
Servere AI: cum arată, cum se răcesc și ce le determină prețul
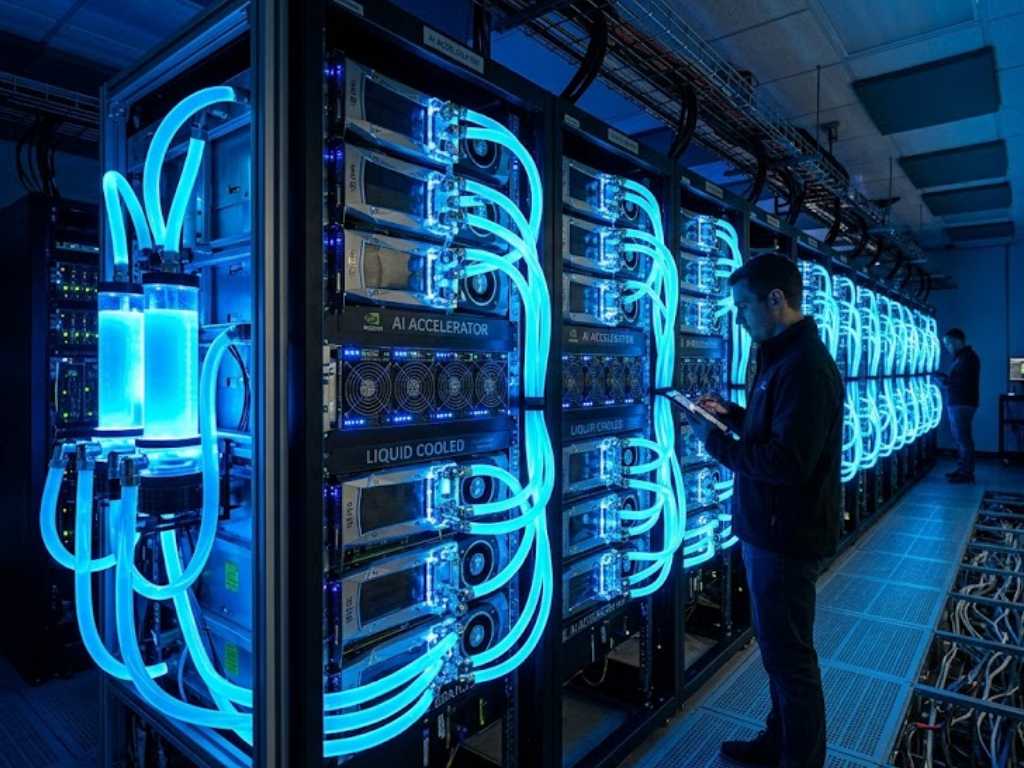
Un server AI modern este în primul rând un accelerator GPU performant cu memorie mare, alimentare de ordinul kilowaților și, tot mai des, cu răcire lichidă – la configurațiile cele mai dense, aerul nu mai este suficient. Prețul este determinat mai ales de clasa plăcilor video și de cantitatea memoriei lor (VRAM): de la o stație de lucru cu una sau două plăci pentru modele mai mici, până la rack-uri întregi NVIDIA Blackwell pentru centre de date. Mai jos găsiți o prezentare a modului în care se compun serverele AI, cum se răcesc și de ce firmele trec de la cloud la hardware propriu.
Rezumat
- Firmele trec la servere AI locale din cauza facturilor tot mai mari pentru API-urile cloud și pentru protecția datelor.
- Modelele deschise mai mici (Gemma 3, Phi-4, Mistral Small 3) pot face o mare parte din sarcinile obișnuite ale unei firme pe hardware propriu.
- Rack-urile cu cele mai noi cipuri au o sarcină termică de peste 100 kW – fără răcire lichidă nu pot fi operate.
- Prețul serverului este influențat cel mai mult de tipul și numărul de GPU-uri și de mărimea memoriei lor.
De ce firmele trec la servere AI locale
Până de curând, firmele mizau mai ales pe modele în cloud. Interogările continue ale sutelor de angajați și agenții AI care rulează în fundal au dus însă la un fenomen numit în domeniu „șocul facturii pentru tokeni” (token bill shock).
Ca reacție, crește tendința spre AI suverană (sovereign AI) și servere locale. În loc să trimită date sensibile pe servere cloud din străinătate, firmele implementează infrastructura în propria rețea. Modelele de limbaj mai mici și optimizate, precum Llama 4 Scout, Mistral Small 3 sau Phi-4, au arătat că o mare parte din sarcinile firmelor poate fi rezolvată local, fără abonamente scumpe.
De ce răcirea cu aer nu mai este suficientă
Principala problemă tehnică a serverelor AI actuale este căldura. Răcirea tradițională cu aer – ventilatoare puternice și climatizare – nu face față densității acestor calcule.
Cipurile din cea mai nouă generație, de exemplu procesoarele grafice NVIDIA Blackwell (GB200) sau acceleratoarele AMD din seria MI, au un consum uriaș. Sarcina termică a unui singur rack de servere depășește astăzi 100–130 kW. Ca termen de comparație: o asemenea căldură ar încălzi iarna un întreg bloc de locuințe.
Cum se răcește infrastructura AI
- Răcire lichidă directă (direct-to-chip) – astăzi cel mai căutat standard. Plăci de răcire din cupru (cold plates) se montează direct pe GPU și procesor, iar lichidul preia căldura chiar de la sursă.
- Răcire prin imersie – serverele sunt complet scufundate într-o cuvă cu lichid dielectric. Permite densitatea maximă a hardware-ului, dar întreținerea este mai complicată.
Datorită circuitelor de lichid, centrele de date pot reduce marile unități externe de răcire (chillere) și pot coborî coeficientul PUE la valori de circa 1,15–1,2. Aceeași fizică o rezolvă și minerii de criptomonede – comparația o găsiți în articolul Unde se termină răcirea cu aer.
Din ce se compune un server AI și ce determină prețul
Pentru marile ecosisteme IT, standardul devin sistemele gata făcute de la Dell sau HPE ori rack-urile pe arhitectura NVIDIA Blackwell NVL72. Firmele medii și implementările locale aleg mai des configurații asamblate la comandă.
| Clasa sistemului | Modele țintă | Hardware tipic | Răcire |
|---|---|---|---|
| Stack local (firmă mică) | Modele mai mici (Gemma 3, Phi-4, Mistral 24B) | Stație de lucru cu 1–2 plăci RTX (24–32 GB VRAM) sau Mac Studio cu 64 GB | Aer performant sau circuit de apă închis (AIO) |
| Server AI pentru firme | Modele deschise mari (Llama 4 Scout, 109B) | Server cu mai multe GPU-uri – plăci de gaming cu VRAM mare sau NVIDIA H100/H200, AMD MI300 | Aer la configurațiile mai mici, lichid direct-to-chip la GPU-urile de centru de date |
| Centru de date | Antrenarea modelelor, clustere de agenți AI | Rack-uri pe arhitectura NVIDIA Blackwell GB200 | Complet lichidă (unități CDU, turnuri de răcire) |
Prețul configurației este determinat mai ales de:
- GPU-uri și memoria lor (VRAM) – mărimea modelului pe care serverul îl poate ține în memorie este dată de suma VRAM a tuturor plăcilor. Aceasta este cea mai mare poziție din buget.
- Procesor și memorie operativă – CPU de server cu suficiente linii PCIe și sute de GB de RAM pentru lucrul cu datele.
- Alimentare și răcire – un server cu patru GPU-uri performante consumă circa 2,5–3 kW, un rack de centru de date de la zeci până la peste o sută de kW.
- Rețea – pentru interconectarea mai multor servere la antrenare este nevoie de o rețea rapidă (InfiniBand sau 400GbE).
Un exemplu de clasă medie din oferta noastră: serverul AI cu 4× RTX 5090 are în total 128 GB VRAM, procesor AMD EPYC, 512 GB RAM și un consum de circa 2.650 W. Prețul actual și configurațiile le găsiți la produs.
Ce software se folosește pe serverele AI
Pentru gestionarea puterii locale se folosesc instrumente precum vLLM (pentru sisteme de firmă intens solicitate, cu tehnica PagedAttention) sau Ollama și LM Studio pentru implementarea rapidă a proiectelor-pilot.
Încotro se îndreaptă infrastructura AI
Industria serverelor AI se îndepărtează rapid de modelul „doar închiriați un cloud”. Decisive devin performanța pe watt, protecția datelor și posibilitatea de a conecta sistemele prin protocoale deschise.
Vor reuși firmele care știu să armonizeze performanța noilor cipuri cu posibilitățile reale de alimentare și răcire. AI-ul local a încetat să fie o jucărie scumpă pentru entuziaști și devine baza independenței și eficienței firmelor.
Ce urmează
- Servere AI PC Praha – configurații la comandă, în funcție de modelul pe care doriți să-l rulați.
- Se poate transforma un ASIC Bitcoin în server AI? – de ce nu merge și ce se poate folosi dintr-o fermă de minerit.
- Mining 2.0 – cum se reorientează minerii spre infrastructura AI.
Întrebări frecvente
Kolik VRAM potřebuji na lokální jazykový model?
Proč AI servery potřebují kapalinové chlazení?
Vyplatí se lokální AI server místo cloudu?
Jaký software se na lokální AI používá?
Kolik elektřiny spotřebuje AI server se čtyřmi GPU?
Textul a fost pregătit cu ajutorul AI. Faptele, cifrele și procedurile au fost verificate de Yegor.


