
AI-сервери: як виглядають, як охолоджуються і що визначає їхню ціну
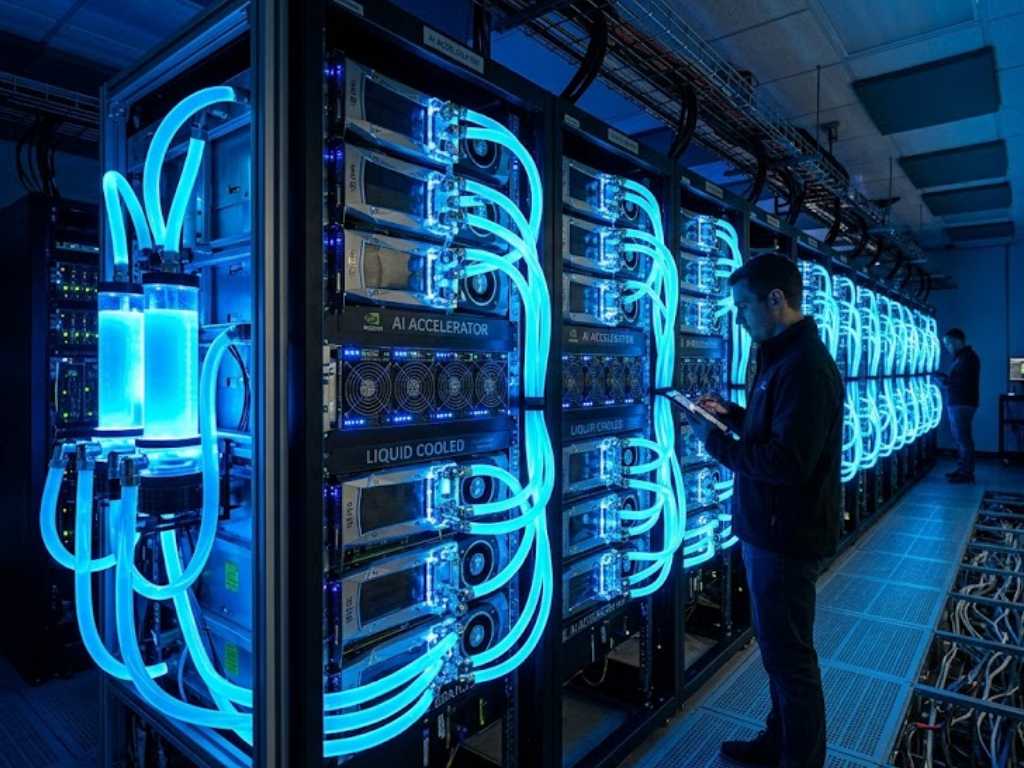
Сучасний AI-сервер – це передусім потужний GPU-прискорювач із великим обсягом пам'яті, живленням у кілька кіловатів і дедалі частіше з рідинним охолодженням: для найщільніших збірок повітря вже не вистачає. Ціну визначають здебільшого клас відеокарт і обсяг їхньої пам'яті (VRAM): від робочої станції з однією-двома картами для невеликих моделей до цілих стійок NVIDIA Blackwell для дата-центрів. Нижче – огляд того, з чого складаються AI-сервери, як вони охолоджуються і чому компанії переходять із хмари на власне обладнання.
Коротко
- Компанії переходять на локальні AI-сервери через зростання рахунків за хмарні API та задля захисту даних.
- Невеликі відкриті моделі (Gemma 3, Phi-4, Mistral Small 3) впораються зі значною частиною типових корпоративних завдань на власному обладнанні.
- Теплове навантаження стійок із найновішими чипами перевищує 100 kW – без рідинного охолодження їх неможливо експлуатувати.
- Найбільше на ціну сервера впливають тип і кількість GPU та обсяг їхньої пам'яті.
Чому компанії переходять на локальні AI-сервери
Ще нещодавно компанії розраховували здебільшого на хмарні моделі. Але постійні запити сотень працівників і AI-агенти, що працюють у фоні, призвели до явища, яке в галузі називають «шоком від рахунків за токени» (token bill shock).
У відповідь набирає сили тренд суверенного AI (sovereign AI) і локальних серверів. Замість того щоб надсилати конфіденційні дані на закордонні хмарні сервери, компанії розгортають інфраструктуру у власній мережі. Оптимізовані невеликі мовні моделі, як-от Llama 4 Scout, Mistral Small 3 чи Phi-4, показали, що значну частину корпоративних завдань можна розв'язувати локально без дорогої передплати.
Чому повітряного охолодження перестає вистачати
Головна технічна проблема сучасних AI-серверів – тепло. Традиційне повітряне охолодження – потужні вентилятори й кондиціювання – не справляється зі щільністю таких обчислень.
Чипи найновішого покоління, наприклад графічні процесори NVIDIA Blackwell (GB200) або прискорювачі AMD серії MI, споживають величезну потужність. Теплове навантаження однієї серверної стійки сьогодні перевищує 100–130 kW. Для порівняння: таким теплом узимку можна опалити цілий багатоквартирний будинок.
Як охолоджується AI-інфраструктура
- Пряме рідинне охолодження (direct-to-chip) – сьогодні найзатребуваніший стандарт. Мідні охолоджувальні пластини (cold plates) монтуються безпосередньо на GPU та процесор, і рідина відводить тепло прямо від джерела.
- Імерсійне (занурювальне) охолодження – сервери повністю занурені у ванну з діелектричною рідиною. Це дає змогу досягти максимальної щільності обладнання, але обслуговування складніше.
Завдяки рідинним контурам дата-центри можуть скоротити використання великих зовнішніх холодильних установок (чилерів) і знизити коефіцієнт PUE до значень близько 1,15–1,2. Ту саму фізику розв'язують і майнери криптовалют – порівняння ви знайдете у статті Де закінчується повітряне охолодження.
З чого складається AI-сервер і що визначає ціну
Для великих IT-екосистем стандартом стають готові системи від Dell чи HPE або стійки на архітектурі NVIDIA Blackwell NVL72. Середні компанії та локальні впровадження частіше обирають конфігурації, зібрані під замовлення.
| Клас системи | Цільові моделі | Типове обладнання | Охолодження |
|---|---|---|---|
| Локальний стек (невелика компанія) | Невеликі моделі (Gemma 3, Phi-4, Mistral 24B) | Робоча станція з 1–2 картами RTX (24–32 GB VRAM) або Mac Studio з 64 GB | Потужне повітряне або замкнений водяний контур (AIO) |
| Корпоративний AI-сервер | Великі відкриті моделі (Llama 4 Scout, 109B) | Сервер із кількома GPU – ігрові карти з великим обсягом VRAM або NVIDIA H100/H200, AMD MI300 | Повітря для невеликих збірок, для GPU дата-центрового класу – рідина direct-to-chip |
| Дата-центр | Навчання моделей, кластери AI-агентів | Стійки на архітектурі NVIDIA Blackwell GB200 | Повністю рідинне (блоки CDU, градирні) |
Ціну збірки визначають здебільшого:
- GPU та їхня пам'ять (VRAM) – розмір моделі, яку сервер утримає в пам'яті, визначається сумарною VRAM усіх карт. Це найбільша стаття бюджету.
- Процесор і оперативна пам'ять – серверний CPU з достатньою кількістю ліній PCIe та сотні GB RAM для роботи з даними.
- Живлення й охолодження – сервер із чотирма потужними GPU споживає близько 2,5–3 kW, стійка дата-центру – від десятків до понад сто kW.
- Мережа – для об'єднання кількох серверів під час навчання потрібна швидка мережа (InfiniBand або 400GbE).
Приклад середнього класу з нашого асортименту: AI-сервер із 4× RTX 5090 має загалом 128 GB VRAM, процесор AMD EPYC, 512 GB RAM і споживану потужність близько 2 650 W. Актуальну ціну та конфігурації дивіться на сторінці товару.
Яке ПЗ використовується на AI-серверах
Для керування локальними потужностями використовують такі інструменти, як vLLM (для навантажених корпоративних систем, із технологією PagedAttention) або Ollama та LM Studio для швидкого запуску пілотних проєктів.
Куди рухається AI-інфраструктура
Галузь AI-серверів швидко відходить від моделі «просто орендуй хмару». Вирішальними стають продуктивність на ват, захист даних і можливість під'єднувати системи через відкриті протоколи.
Успіху досягнуть компанії, які зуміють узгодити продуктивність нових чипів із реальними можливостями живлення та охолодження. Локальний AI перестав бути дорогою іграшкою для ентузіастів і стає основою незалежності та ефективності компаній.
Що далі
- AI-сервери PC Praha – конфігурації під замовлення залежно від моделі, яку ви хочете запускати.
- Чи можна переробити біткоїн-ASIC на AI-сервер? – чому це неможливо і що з майнінг-ферми використати все-таки можна.
- Mining 2.0 – як майнери переорієнтовуються на AI-інфраструктуру.
Поширені запитання
Скільки VRAM потрібно для локальної мовної моделі?
Чому AI-серверам потрібне рідинне охолодження?
Чи вигідний локальний AI-сервер замість хмари?
Яке програмне забезпечення використовують для локального AI?
Скільки електроенергії споживає AI-сервер із чотирма GPU?
Текст підготовлено за допомогою ШІ. Факти, цифри та порядок дій перевірив Yegor.


