
AI szerverek: hogyan néznek ki, hogyan hűtik őket és mi határozza meg az árukat
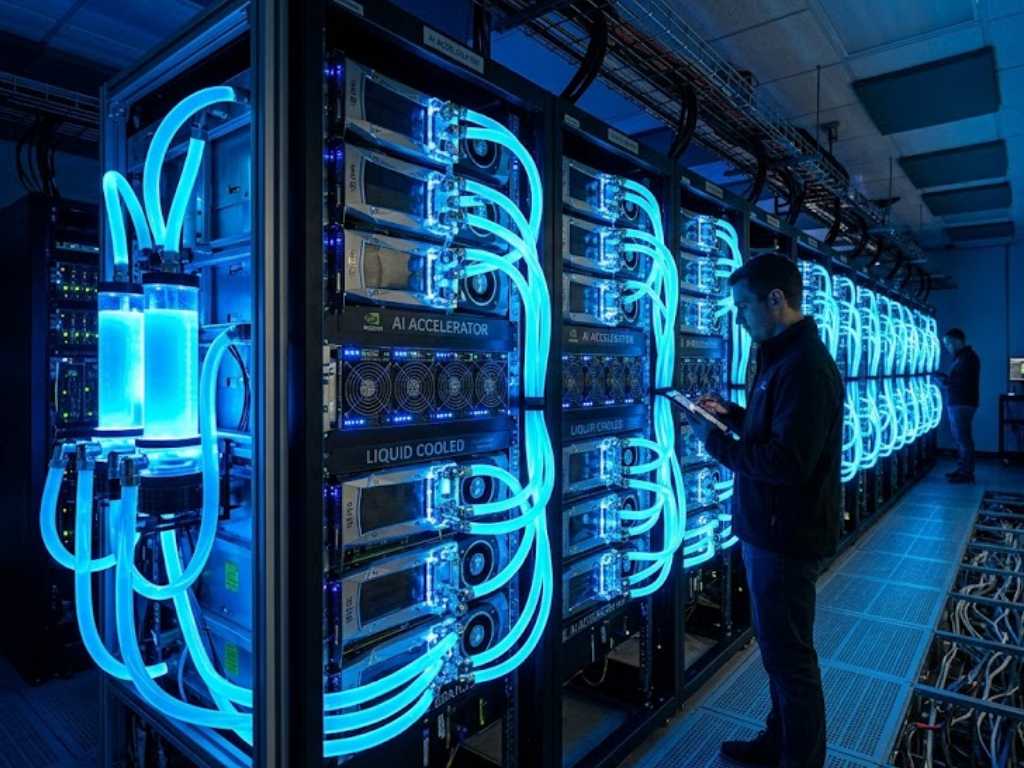
A modern AI szerver mindenekelőtt egy nagy teljesítményű GPU-gyorsító nagy memóriával, kilowattos nagyságrendű tápellátással és egyre gyakrabban folyadékhűtéssel – a legsűrűbb konfigurációknál a levegő már nem elég. Az árat elsősorban a grafikus kártyák kategóriája és memóriájuk (VRAM) mennyisége határozza meg: a kisebb modellekhez való, egy-két kártyás munkaállomástól egészen az adatközpontoknak szánt teljes NVIDIA Blackwell rackekig. Alább áttekintjük, miből áll egy AI szerver, hogyan hűtik, és miért térnek át a cégek a felhőről saját hardverre.
Összefoglalás
- A cégek a felhőalapú API-k egyre magasabb számlái és az adatvédelem miatt térnek át helyi AI szerverekre.
- A kisebb nyílt modellek (Gemma 3, Phi-4, Mistral Small 3) a szokásos vállalati feladatok jelentős részét saját hardveren is elvégzik.
- A legújabb chipekkel szerelt rackek hőterhelése meghaladja a 100 kW-ot – folyadékhűtés nélkül nem üzemeltethetők.
- A szerver árát leginkább a GPU-k típusa és száma, valamint memóriájuk mérete befolyásolja.
Miért térnek át a cégek helyi AI szerverekre
Nem sokkal ezelőtt a cégek még főként felhőalapú modellekkel számoltak. Az alkalmazottak százainak folyamatos lekérdezései és a háttérben futó AI ügynökök azonban olyan jelenséghez vezettek, amelyet a szakmában „tokenszámla-sokknak” (token bill shock) neveznek.
Erre válaszul erősödik a szuverén AI (sovereign AI) és a helyi szerverek irányzata. Ahelyett, hogy érzékeny adataikat külföldi felhőszerverekre küldenék, a cégek saját hálózatukban telepítenek infrastruktúrát. Az optimalizált kisebb nyelvi modellek, mint a Llama 4 Scout, Mistral Small 3 vagy a Phi-4, megmutatták, hogy a vállalati feladatok nagy része helyben, drága előfizetés nélkül is megoldható.
Miért nem elég már a léghűtés
A mai AI szerverek fő műszaki problémája a hő. A hagyományos léghűtés – nagy teljesítményű ventilátorok és klimatizálás – nem bírja az ilyen számítások sűrűségét.
A legújabb generációs chipek, például az NVIDIA Blackwell (GB200) grafikus processzorok vagy az AMD MI sorozatú gyorsítói, hatalmas teljesítményt vesznek fel. Egyetlen szerverrack hőterhelése ma meghaladja a 100–130 kW-ot. Szemléltetésül: ennyi hő télen egy egész lakóházat kifűtene.
Hogyan hűtik az AI infrastruktúrát
- Közvetlen folyadékhűtés (direct-to-chip) – ma a legkeresettebb szabvány. A réz hűtőlapokat (cold plates) közvetlenül a GPU-ra és a processzorra szerelik, a folyadék pedig közvetlenül a forrásnál vezeti el a hőt.
- Immerziós (merülő) hűtés – a szervereket teljesen dielektromos folyadékkal teli kádba merítik. Maximális hardversűrűséget tesz lehetővé, a karbantartás viszont bonyolultabb.
A folyadékkörök révén az adatközpontok csökkenthetik a nagy külső hűtőegységek (chillerek) használatát, és a PUE-értéket 1,15–1,2 körüli szintre szoríthatják le. Ugyanezzel a fizikával küzdenek a kriptobányászok is – az összehasonlítást a Hol ér véget a léghűtés című cikkben találja.
Miből áll egy AI szerver és mi határozza meg az árát
A nagy IT-ökoszisztémák számára a Dell vagy a HPE kész rendszerei, illetve az NVIDIA Blackwell NVL72 architektúrájú rackek válnak szabvánnyá. A közepes cégek és a helyi telepítések gyakrabban választanak egyedileg összeállított konfigurációkat.
| Rendszerkategória | Célmodellek | Jellemző hardver | Hűtés |
|---|---|---|---|
| Helyi stack (kis cég) | Kisebb modellek (Gemma 3, Phi-4, Mistral 24B) | Munkaállomás 1–2 RTX kártyával (24–32 GB VRAM) vagy Mac Studio 64 GB-tal | Nagy teljesítményű léghűtés vagy zárt vízhűtés (AIO) |
| Vállalati AI szerver | Nagy nyílt modellek (Llama 4 Scout, 109B) | Több GPU-s szerver – nagy VRAM-mal rendelkező gamer kártyák vagy NVIDIA H100/H200, AMD MI300 | Kisebb konfigurációknál levegő, adatközponti GPU-knál direct-to-chip folyadékhűtés |
| Adatközpont | Modellek tanítása, AI ügynök-klaszterek | NVIDIA Blackwell GB200 architektúrájú rackek | Teljesen folyadékhűtéses (CDU egységek, hűtőtornyok) |
A konfiguráció árát elsősorban ezek határozzák meg:
- A GPU-k és memóriájuk (VRAM) – hogy mekkora modellt tud a szerver a memóriában tartani, azt az összes kártya VRAM-jának összege adja meg. Ez a költségvetés legnagyobb tétele.
- Processzor és operatív memória – szerver CPU elegendő PCIe sávval és több száz GB RAM-mal az adatokkal végzett munkához.
- Tápellátás és hűtés – egy négy nagy teljesítményű GPU-val szerelt szerver kb. 2,5–3 kW-ot vesz fel, egy adatközponti rack tíz kilowattoktól akár száz kW fölé is.
- Hálózat – több szerver összekapcsolásához tanítás közben gyors hálózat szükséges (InfiniBand vagy 400GbE).
Egy középkategóriás példa kínálatunkból: az AI szerver 4× RTX 5090 kártyával összesen 128 GB VRAM-mal, AMD EPYC processzorral, 512 GB RAM-mal és kb. 2 650 W teljesítményfelvétellel rendelkezik. Az aktuális árat és konfigurációkat a terméknél találja.
Milyen szoftvereket használnak az AI szervereken
A helyi teljesítmény kezelésére olyan eszközöket használnak, mint a vLLM (nagy terhelésű vállalati rendszerekhez, PagedAttention technikával), illetve az Ollama és az LM Studio a pilotprojektek gyors elindításához.
Merre tart az AI infrastruktúra
Az AI szerverek ágazata gyorsan távolodik a „csak béreljen felhőt” modelltől. Döntővé válik a wattonkénti teljesítmény, az adatvédelem és a rendszerek nyílt protokollokon keresztüli összekapcsolhatósága.
Azok a cégek lesznek sikeresek, amelyek össze tudják hangolni az új chipek teljesítményét a tápellátás és a hűtés valós lehetőségeivel. A helyi AI már nem a lelkes rajongók drága játékszere, hanem a cégek függetlenségének és hatékonyságának alapja.
További olvasnivaló
- PC Praha AI szerverek – egyedi konfigurációk aszerint, hogy melyik modellt szeretné futtatni.
- Átalakítható-e egy Bitcoin ASIC AI szerverré? – miért nem lehetséges, és mit lehet felhasználni egy bányafarmból.
- Mining 2.0 – hogyan állnak át a bányászok az AI infrastruktúrára.
Gyakori kérdések
Mennyi VRAM kell egy helyi nyelvi modellhez?
Miért van szükségük az AI szervereknek folyadékhűtésre?
Megéri helyi AI szervert használni felhő helyett?
Milyen szoftvert használnak helyi AI-hoz?
Mennyi áramot fogyaszt egy négy GPU-s AI szerver?
A szöveg AI segítségével készült. A tényeket, számokat és eljárásokat Yegor ellenőrizte.


