
KI-Server: Wie sie aussehen, wie sie gekühlt werden und was ihren Preis bestimmt
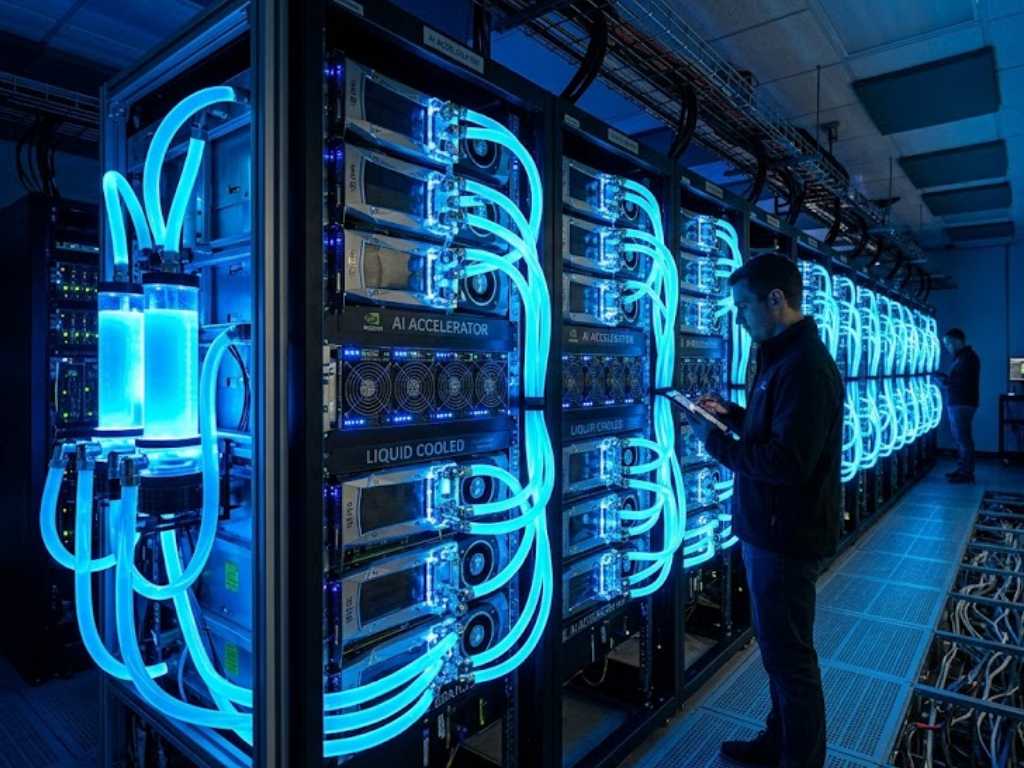
Ein moderner KI-Server ist vor allem ein leistungsstarker GPU-Beschleuniger mit großem Speicher, einer Stromversorgung im Kilowattbereich und immer häufiger mit Flüssigkeitskühlung – Luft reicht bei den dichtesten Systemen nicht mehr aus. Den Preis bestimmen vor allem die Klasse der Grafikkarten und die Menge ihres Speichers (VRAM): von der Workstation mit einer oder zwei Karten für kleinere Modelle bis zu ganzen NVIDIA-Blackwell-Racks für Rechenzentren. Unten finden Sie einen Überblick, wie KI-Server aufgebaut sind, wie sie gekühlt werden und warum Firmen von der Cloud auf eigene Hardware umsteigen.
Zusammenfassung
- Firmen steigen wegen steigender Rechnungen für Cloud-APIs und zum Schutz ihrer Daten auf lokale KI-Server um.
- Kleinere offene Modelle (Gemma 3, Phi-4, Mistral Small 3) bewältigen einen großen Teil der üblichen Firmenaufgaben auf eigener Hardware.
- Racks mit den neuesten Chips haben eine Wärmelast von über 100 kW – ohne Flüssigkeitskühlung lassen sie sich nicht betreiben.
- Den Preis eines Servers beeinflussen am stärksten Typ und Anzahl der GPUs und die Größe ihres Speichers.
Warum Firmen auf lokale KI-Server umsteigen
Noch vor Kurzem setzten Firmen vor allem auf Cloud-Modelle. Ständige Anfragen von Hunderten Mitarbeitern und im Hintergrund laufende KI-Agenten führten aber zu einem Phänomen, das die Branche „Token-Rechnungsschock“ (token bill shock) nennt.
Als Reaktion darauf wächst der Trend zu souveräner KI (sovereign AI) und lokalen Servern. Statt sensible Daten an ausländische Cloud-Server zu senden, setzen Firmen Infrastruktur im eigenen Netzwerk ein. Optimierte kleinere Sprachmodelle wie Llama 4 Scout, Mistral Small 3 oder Phi-4 haben gezeigt, dass sich ein großer Teil der Firmenaufgaben lokal ohne teures Abonnement lösen lässt.
Warum die Luftkühlung nicht mehr ausreicht
Das technische Hauptproblem heutiger KI-Server ist die Wärme. Die traditionelle Luftkühlung – leistungsstarke Lüfter und Klimaanlagen – bewältigt die Dichte dieser Berechnungen nicht.
Chips der neuesten Generation, etwa die Grafikprozessoren NVIDIA Blackwell (GB200) oder Beschleuniger der AMD-MI-Serie, haben eine enorme Leistungsaufnahme. Die Wärmelast eines einzigen Server-Racks übersteigt heute 100–130 kW. Zur Veranschaulichung: So viel Wärme würde im Winter ein ganzes Mehrfamilienhaus heizen.
Wie KI-Infrastruktur gekühlt wird
- Direkte Flüssigkeitskühlung (Direct-to-Chip) – heute der gefragteste Standard. Kühlplatten aus Kupfer (Cold Plates) werden direkt auf GPU und Prozessor montiert, und die Flüssigkeit führt die Wärme direkt an der Quelle ab.
- Immersionskühlung (Tauchkühlung) – die Server sind vollständig in einem Becken mit dielektrischer Flüssigkeit eingetaucht. Das ermöglicht maximale Hardwaredichte, die Wartung ist aber aufwändiger.
Dank Flüssigkeitskreisläufen können Rechenzentren große externe Kühlaggregate (Chiller) reduzieren und den PUE-Wert auf etwa 1,15–1,2 senken. Mit derselben Physik befassen sich auch Krypto-Miner – einen Vergleich finden Sie im Artikel Wo die Luftkühlung endet.
Woraus ein KI-Server besteht und was den Preis bestimmt
Für große IT-Ökosysteme werden fertige Systeme von Dell oder HPE oder Racks auf Basis der Architektur NVIDIA Blackwell NVL72 zum Standard. Mittelständische Firmen und lokale Installationen wählen häufiger maßgeschneiderte Konfigurationen.
| Systemklasse | Zielmodelle | Typische Hardware | Kühlung |
|---|---|---|---|
| Lokaler Stack (kleine Firma) | Kleinere Modelle (Gemma 3, Phi-4, Mistral 24B) | Workstation mit 1–2 RTX-Karten (24–32 GB VRAM) oder Mac Studio mit 64 GB | Leistungsstarke Luftkühlung oder geschlossener Wasserkreislauf (AIO) |
| Firmen-KI-Server | Große offene Modelle (Llama 4 Scout, 109B) | Server mit mehreren GPUs – Gaming-Karten mit viel VRAM oder NVIDIA H100/H200, AMD MI300 | Luft bei kleineren Systemen, bei Rechenzentrums-GPUs Flüssigkeit Direct-to-Chip |
| Rechenzentrum | Training von Modellen, Cluster von KI-Agenten | Racks auf Basis der Architektur NVIDIA Blackwell GB200 | Vollständig flüssig (CDU-Einheiten, Kühltürme) |
Den Preis einer Konfiguration bestimmen vor allem:
- GPUs und ihr Speicher (VRAM) – die Größe des Modells, das der Server im Speicher halten kann, ergibt sich aus der Summe des VRAM aller Karten. Das ist der größte Posten im Budget.
- Prozessor und Arbeitsspeicher – eine Server-CPU mit ausreichend PCIe-Lanes und Hunderten GB RAM für die Arbeit mit Daten.
- Stromversorgung und Kühlung – ein Server mit vier leistungsstarken GPUs nimmt etwa 2,5–3 kW auf, ein Rechenzentrums-Rack Dutzende bis über hundert kW.
- Netzwerk – für die Verbindung mehrerer Server beim Training ist ein schnelles Netzwerk nötig (InfiniBand oder 400GbE).
Ein Beispiel der Mittelklasse aus unserem Angebot: Der KI-Server mit 4× RTX 5090 hat insgesamt 128 GB VRAM, einen AMD-EPYC-Prozessor, 512 GB RAM und eine Leistungsaufnahme von rund 2.650 W. Den aktuellen Preis und die Konfigurationen finden Sie beim Produkt.
Welche Software auf KI-Servern verwendet wird
Zur Verwaltung lokaler Rechenleistung werden Tools wie vLLM (für ausgelastete Firmensysteme, mit der Technik PagedAttention) oder Ollama und LM Studio für die schnelle Umsetzung von Pilotprojekten eingesetzt.
Wohin sich die KI-Infrastruktur entwickelt
Die Branche der KI-Server entfernt sich schnell vom Modell „einfach Cloud mieten“. Entscheidend werden Leistung pro Watt, Datenschutz und die Möglichkeit, Systeme über offene Protokolle anzubinden.
Erfolgreich werden Firmen sein, die die Leistung neuer Chips mit den realen Möglichkeiten von Stromversorgung und Kühlung in Einklang bringen. Lokale KI ist kein teures Spielzeug für Enthusiasten mehr, sondern wird zur Grundlage der Unabhängigkeit und Effizienz von Firmen.
Wie es weitergeht
- KI-Server von PC Praha – maßgeschneiderte Konfigurationen je nach dem Modell, das Sie betreiben möchten.
- Lässt sich ein Bitcoin-ASIC zum KI-Server umbauen? – warum das nicht geht und was sich von einer Mining-Farm nutzen lässt.
- Mining 2.0 – wie sich Miner auf KI-Infrastruktur umorientieren.
Häufige Fragen
Wie viel VRAM brauche ich für ein lokales Sprachmodell?
Warum brauchen KI-Server Flüssigkeitskühlung?
Lohnt sich ein lokaler KI-Server statt der Cloud?
Welche Software wird für lokale KI verwendet?
Wie viel Strom verbraucht ein KI-Server mit vier GPUs?
Dieser Text wurde mithilfe von KI erstellt. Fakten, Zahlen und Abläufe hat Yegor geprüft.


