
Serwery AI: jak wyglądają, jak się je chłodzi i co decyduje o ich cenie
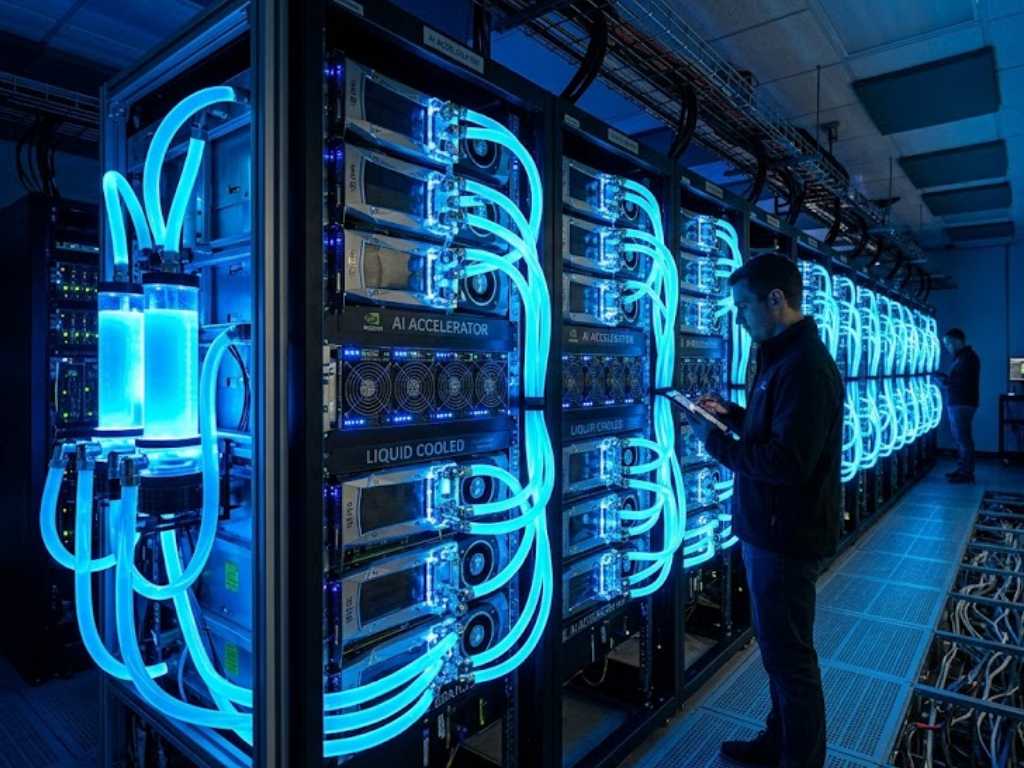
Nowoczesny serwer AI to przede wszystkim wydajny akcelerator GPU z dużą pamięcią, zasilaniem rzędu kilowatów i coraz częściej z chłodzeniem cieczą – przy najgęstszych konfiguracjach powietrze już nie wystarcza. O cenie decyduje głównie klasa kart graficznych i ilość ich pamięci (VRAM): od stacji roboczej z jedną lub dwiema kartami dla mniejszych modeli aż po całe szafy rack NVIDIA Blackwell dla centrów danych. Poniżej znajdą Państwo przegląd tego, z czego składają się serwery AI, jak się je chłodzi i dlaczego firmy przechodzą z chmury na własny sprzęt.
Podsumowanie
- Firmy przechodzą na lokalne serwery AI z powodu rosnących rachunków za chmurowe API oraz ze względu na ochronę danych.
- Mniejsze otwarte modele (Gemma 3, Phi-4, Mistral Small 3) radzą sobie z dużą częścią typowych zadań firmowych na własnym sprzęcie.
- Szafy rack z najnowszymi chipami generują obciążenie cieplne ponad 100 kW – bez chłodzenia cieczą nie da się ich eksploatować.
- Na cenę serwera najbardziej wpływa typ i liczba GPU oraz wielkość ich pamięci.
Dlaczego firmy przechodzą na lokalne serwery AI
Jeszcze niedawno firmy liczyły głównie na modele w chmurze. Nieustanne zapytania setek pracowników i agenci AI działający w tle doprowadziły jednak do zjawiska, które w branży nazywa się „szokiem z rachunku za tokeny” (token bill shock).
W odpowiedzi na to rośnie trend suwerennej AI (sovereign AI) i lokalnych serwerów. Zamiast wysyłać wrażliwe dane na zagraniczne serwery chmurowe, firmy wdrażają infrastrukturę we własnej sieci. Zoptymalizowane mniejsze modele językowe, takie jak Llama 4 Scout, Mistral Small 3 czy Phi-4, pokazały, że dużą część zadań firmowych można realizować lokalnie, bez drogiej subskrypcji.
Dlaczego chłodzenie powietrzem przestaje wystarczać
Głównym problemem technicznym współczesnych serwerów AI jest ciepło. Tradycyjne chłodzenie powietrzem – wydajne wentylatory i klimatyzacja – nie radzi sobie z gęstością tych obliczeń.
Chipy najnowszej generacji, na przykład procesory graficzne NVIDIA Blackwell (GB200) czy akceleratory AMD z serii MI, mają ogromny pobór mocy. Obciążenie cieplne jednej szafy rack przekracza dziś 100–130 kW. Dla porównania: takim ciepłem można by zimą ogrzać cały blok mieszkalny.
Jak chłodzi się infrastrukturę AI
- Bezpośrednie chłodzenie cieczą (direct-to-chip) – obecnie najbardziej pożądany standard. Miedziane płyty chłodzące (cold plates) montuje się bezpośrednio na GPU i procesorze, a ciecz odprowadza ciepło prosto od źródła.
- Chłodzenie immersyjne (zanurzeniowe) – serwery są w całości zanurzone w wannie z cieczą dielektryczną. Pozwala to na maksymalną gęstość sprzętu, ale serwis jest bardziej skomplikowany.
Dzięki obiegom cieczowym centra danych mogą ograniczyć duże zewnętrzne agregaty chłodnicze (chillery) i obniżyć współczynnik PUE do wartości około 1,15–1,2. Tę samą fizykę rozwiązują też górnicy kryptowalut – porównanie znajdą Państwo w artykule Gdzie kończy się chłodzenie powietrzem.
Z czego składa się serwer AI i co decyduje o cenie
W dużych ekosystemach IT standardem stają się gotowe systemy od Della czy HPE albo szafy rack w architekturze NVIDIA Blackwell NVL72. Średnie firmy i wdrożenia lokalne częściej wybierają konfiguracje składane na zamówienie.
| Klasa systemu | Docelowe modele | Typowy sprzęt | Chłodzenie |
|---|---|---|---|
| Lokalny stack (mała firma) | Mniejsze modele (Gemma 3, Phi-4, Mistral 24B) | Stacja robocza z 1–2 kartami RTX (24–32 GB VRAM) lub Mac Studio z 64 GB | Wydajne powietrzne lub zamknięty obieg wodny (AIO) |
| Firmowy serwer AI | Duże otwarte modele (Llama 4 Scout, 109B) | Serwer z wieloma GPU – karty gamingowe z dużą VRAM lub NVIDIA H100/H200, AMD MI300 | Powietrze przy mniejszych konfiguracjach, przy GPU do centrów danych ciecz direct-to-chip |
| Centrum danych | Trenowanie modeli, klastry agentów AI | Szafy rack w architekturze NVIDIA Blackwell GB200 | W pełni cieczowe (jednostki CDU, wieże chłodnicze) |
O cenie zestawu decydują głównie:
- GPU i ich pamięć (VRAM) – wielkość modelu, jaki serwer utrzyma w pamięci, wynika z sumy VRAM wszystkich kart. To największa pozycja budżetu.
- Procesor i pamięć operacyjna – serwerowe CPU z wystarczającą liczbą linii PCIe i setkami GB RAM do pracy z danymi.
- Zasilanie i chłodzenie – serwer z czterema wydajnymi GPU pobiera około 2,5–3 kW, szafa rack w centrum danych od kilkudziesięciu do ponad stu kW.
- Sieć – do połączenia wielu serwerów przy trenowaniu potrzebna jest szybka sieć (InfiniBand lub 400GbE).
Przykład ze średniej półki z naszej oferty: serwer AI z 4× RTX 5090 ma łącznie 128 GB VRAM, procesor AMD EPYC, 512 GB RAM i pobór mocy około 2 650 W. Aktualną cenę i konfiguracje znajdą Państwo na stronie produktu.
Jakie oprogramowanie stosuje się na serwerach AI
Do zarządzania lokalną mocą obliczeniową używa się narzędzi takich jak vLLM (dla obciążonych systemów firmowych, z techniką PagedAttention) lub Ollama i LM Studio do szybkiego wdrażania projektów pilotażowych.
Dokąd zmierza infrastruktura AI
Branża serwerów AI szybko odchodzi od modelu „po prostu wynajmij chmurę”. Decydujące stają się wydajność na wat, ochrona danych i możliwość łączenia systemów za pomocą otwartych protokołów.
Sukces odniosą firmy, które potrafią pogodzić wydajność nowych chipów z realnymi możliwościami zasilania i chłodzenia. Lokalna AI przestała być drogą zabawką dla entuzjastów i staje się podstawą niezależności i efektywności firm.
Co dalej
- Serwery AI PC Praha – konfiguracje na zamówienie dopasowane do modelu, który chcą Państwo uruchamiać.
- Czy da się przerobić Bitcoin ASIC na serwer AI? – dlaczego to niemożliwe i co z kopalni kryptowalut można wykorzystać.
- Mining 2.0 – jak górnicy przestawiają się na infrastrukturę AI.
Częste pytania
Ile VRAM potrzebuję do lokalnego modelu językowego?
Dlaczego serwery AI potrzebują chłodzenia cieczą?
Czy lokalny serwer AI opłaca się zamiast chmury?
Jakiego oprogramowania używa się do lokalnej AI?
Ile prądu zużywa serwer AI z czterema GPU?
Tekst został przygotowany z pomocą AI. Fakty, liczby i procedury sprawdził Yegor.


