GPU do lokalnej AI w 2026 roku: RTX 5090 czy RTX PRO 6000 Blackwell?
W przypadku lokalnej AI decyduje przede wszystkim pamięć graficzna (VRAM): model musi się w niej zmieścić w całości, razem z zapasem na kontekst. Na GeForce RTX 5090 z 32 GB zmieści się według poniższego wzoru model do około 25 miliardów parametrów w 8 bitach. W 4 bitach to około 45 miliardów. RTX PRO 6000 Blackwell z 96 GB udźwignie na jednej karcie model do około 80 miliardów parametrów w 8 bitach. W 4 bitach poradzi sobie z około 140 miliardami. Do jeszcze większych modeli potrzeba więcej kart.
Podsumowanie
- Potrzebną VRAM można policzyć w prosty sposób: parametry w miliardach × bajty na wagę × 1,2. W 4 bitach to około 0,6 GB na miliard parametrów.
- RTX 5090 (32 GB, 575 W) to najtańszy start dla modeli do około 45 mld parametrów w 4 bitach. Gotowy komputer z tą kartą kosztuje u nas od 200 990 Kč.
- RTX PRO 6000 Blackwell (96 GB, 300–600 W zależnie od edycji) ma trzy razy więcej pamięci na jednej karcie. Stacja robocza z tą kartą kosztuje od 625 290 Kč.
- Powyżej 96 GB VRAM 1 GB kosztuje w najtańszym zestawie z RTX PRO 6000 5 932 Kč, z RTX 5090 8 609 Kč (na dzień 4.11.2026).
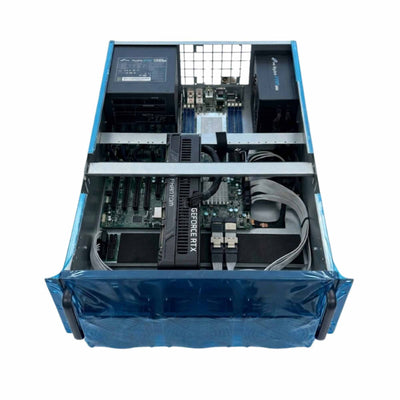
- Serwer z 4 kartami pobiera około 2,7 kW, ośmiokartowy ponad 5 kW. To już wymaga innego obwodu niż zwykłe gniazdko.
Jesteśmy sprzedawcą: wszystkie karty i zestawy z tabel mamy w sprzedaży. Ceny pochodzą z naszej oferty na dzień 4.11.2026 i zawierają VAT, parametry kart pochodzą z oficjalnych stron NVIDIA.
Jak obliczyć, ile VRAM potrzebuje model?
Model z 32 miliardami parametrów potrzebuje w 4 bitach około 19 GB VRAM. Liczymy to według wzoru:
VRAM [GB] ≈ liczba parametrów [mld] × bajty na wagę × 1,2
- Bajty na wagę określa kwantyzacja (kompresja wag modelu): FP16 = 2 bajty, 8 bitów (Q8) = 1 bajt, 4 bity (Q4) = 0,5 bajta.
- × 1,2 to zapas około 20 % na KV cache (pamięć na kontekst rozmowy) i działanie oprogramowania.
Zapas 20 % to zgrubna reguła dla jednego użytkownika i kontekstu o typowej długości. Długie dokumenty lub kilku użytkowników jednocześnie wymagają więcej pamięci na KV cache. Rzeczywiste formaty 4-bitowe mają często nieco więcej niż 4 bity na wagę, dlatego lepiej liczyć z górną granicą.
Wzór sprawdza się też na rzeczywistym modelu. OpenAI podaje, że gpt-oss-120b (117 mld parametrów, natywnie w 4-bitowym formacie MXFP4) działa w 80 GB pamięci. Według wzoru wychodzi 117 × 0,5 × 1,2 = 70 GB.
W modelach typu MoE (mixture of experts) w pamięci muszą być wszystkie parametry, mimo że podczas obliczeń pracuje tylko ich część. W gpt-oss-120b to 5,1 mld aktywnych parametrów ze 117 mld. Pamięć należy więc liczyć z łącznej liczby.
Jaki model zmieści się na RTX 5090, a jaki na RTX PRO 6000?
Na jednej RTX 5090 zmieści się według wzoru model do około 25 mld parametrów w 8 bitach lub do 45 mld w 4 bitach. Tabela pokazuje potrzebną VRAM dla typowych wielkości modeli i najmniejszy zestaw, jaki do tego sprzedajemy:
| Wielkość modelu (mld parametrów) | FP16 (GB VRAM → zestaw) | Q8 (GB VRAM → zestaw) | Q4 (GB VRAM → zestaw) |
|---|---|---|---|
| 8 | 19,2 GB → 1× RTX 5090 | 9,6 GB → 1× RTX 5090 | 4,8 GB → 1× RTX 5090 |
| 14 | 33,6 GB → 2× RTX 5090 | 16,8 GB → 1× RTX 5090 | 8,4 GB → 1× RTX 5090 |
| 32 | 76,8 GB → 1× RTX PRO 6000 | 38,4 GB → 2× RTX 5090 | 19,2 GB → 1× RTX 5090 |
| 70 | 168 GB → 2× RTX PRO 6000 | 84 GB → 1× RTX PRO 6000 | 42 GB → 2× RTX 5090 |
| 120 | 288 GB → 4× RTX PRO 6000 | 144 GB → 2× RTX PRO 6000 | 72 GB → 1× RTX PRO 6000 |
| 235 | 564 GB → 6× RTX PRO 6000 | 282 GB → 4× RTX PRO 6000 | 141 GB → 2× RTX PRO 6000 |
| 405 | 972 GB → 16× RTX PRO 6000 | 486 GB → 6× RTX PRO 6000 | 243 GB → 8× RTX 5090 lub 4× RTX PRO 6000 |
Gdy model zostaje podzielony między kilka kart, karty przekazują sobie dane przez magistralę PCIe. Jedna karta z dużą pamięcią jest więc prostszym rozwiązaniem niż kilka mniejszych o tej samej łącznej VRAM. Do modeli między 32 a 48 GB wystarczy też jedna RTX PRO 5000 Blackwell z 48 GB. W 4 bitach oszczędza się pamięć kosztem pewnej utraty dokładności; jak dużej, zależy od konkretnego modelu.
Jakie parametry mają karty do lokalnej AI?
RTX 5090 i RTX PRO 6000 Workstation mają tę samą przepustowość pamięci 1 792 GB/s, różnią się głównie wielkością VRAM: 32 GB wobec 96 GB. Przegląd kart, które sprzedajemy osobno lub w zestawach:
| Karta | VRAM (GB) | Przepustowość pamięci (GB/s) | Maks. pobór mocy (W) | Wydajność AI według NVIDIA | Cena u nas (Kč z VAT) |
|---|---|---|---|---|---|
| GeForce RTX 5080 | 16 GDDR7 | 960 | 360 | 1 801 AI TOPS¹ | – osobno; stacje od 169 790 |
| GeForce RTX 5090 | 32 GDDR7 | 1 792 | 575 | 3 352 AI TOPS¹ | – osobno; zestawy od 200 990 |
| RTX PRO 4000 Blackwell | 24 GDDR7 ECC | 672 | 145 | 1 290 TOPS FP4² | 82 990 |
| RTX PRO 4500 Blackwell | 32 GDDR7 ECC | 896 | 200 | nie podano | 115 590 |
| RTX PRO 5000 Blackwell | 48 GDDR7 ECC | 1 344 | 300 | 2 064 AI TOPS³ | 200 090 |
| RTX PRO 6000 Blackwell Workstation Edition | 96 GDDR7 ECC | 1 792 | 600 | 4 000 TOPS FP4² | – osobno; stacje od 625 290* |
| RTX PRO 6000 Blackwell Max-Q | 96 GDDR7 ECC | 1 792 | 300 | 3 511 TOPS FP4² | – osobno; stacje od 625 290* |
| RTX PRO 6000 Blackwell Server Edition | 96 GDDR7 ECC | 1 597 | do 600 (regulowany) | FP4 4 PFLOPS, FP8 2 PFLOPS | 442 290 (przedsprzedaż) |
| NVIDIA L40 | 48 GDDR6 ECC | 864 | 300 | – | – osobno; serwer 2× L40 od 753 090 |
| NVIDIA L4 | 24 | 300 | 72 | FP8 485 TFLOPS⁴ | – osobno; serwer 2× L4 od 432 590 |
| NVIDIA DGX Spark (GB10, cały komputer) | 128 współdzielonej LPDDR5x | 273 | zasilacz 240 | 1 PFLOP FP4² | 220 090 (inne maszyny z GB10 od 163 890) |
¹ NVIDIA podaje „AI TOPS” bez określenia precyzji. ² Teoretyczna wydajność FP4 z wykorzystaniem rzadkości (sparsity) według NVIDIA. ³ NVIDIA nie podaje precyzji. ⁴ Z rzadkością, bez niej o połowę mniej. * Edycję RTX PRO 6000 w zestawie (Workstation lub Max-Q) potwierdzimy w ofercie.
Wartości TOPS i PFLOPS to teoretyczne maksima producenta i nie można ich bezpośrednio porównywać między seriami GeForce i PRO. Szybkość generowania tekstu dla jednego użytkownika ogranicza głównie przepustowość pamięci: dla każdego nowego słowa karta musi przejść przez aktywne wagi modelu. Dlatego DGX Spark ze 128 GB udźwignie duży model, ale przy przepustowości 273 GB/s generuje wolniej niż karta z 1 792 GB/s.
Kiedy wystarczy RTX 5090?
RTX 5090 wystarczy, gdy wystarczy Państwu model do około 45 mld parametrów w 4 bitach (do 25 mld w 8 bitach) i od jednego do kilku użytkowników. Typowo chodzi o asystenta dla programisty, czat nad dokumentami mniejszego zespołu, transkrypcję mowy lub generowanie obrazów.

- Zalety RTX 5090: najniższa cena na start, przepustowość 1 792 GB/s, standardowe oprogramowanie (CUDA, PyTorch, llama.cpp, vLLM).
- Wady RTX 5090: tylko 32 GB, pobór mocy 575 W na kartę, a NVIDIA zaleca zasilacz komputera 1 000 W. NVIDIA nie podaje dla niej pamięci z ECC, w przeciwieństwie do serii PRO. Do modelu 70 mld parametrów potrzeba co najmniej dwóch kart.
Uwaga na cenę: sama RTX 5090 jest dziś na rynku droga. Serwer z 2× RTX 5090 (64 GB) kosztuje u nas 647 790 Kč. Stacja robocza z jedną RTX PRO 6000 (96 GB) wychodzi na 625 290 Kč, czyli nieco taniej.
Kiedy potrzebna jest RTX PRO 6000 Blackwell?
RTX PRO 6000 Blackwell jest potrzebna do modeli około 70 mld parametrów w 8 bitach, 120 mld w 4 bitach albo gdy chcą Państwo uruchomić model 32B w pełnej precyzji FP16. Sprawdza się też tam, gdzie na serwerze zmienia się wiele zadań lub użytkowników.

- Zalety RTX PRO 6000 Blackwell: 96 GB na jednej karcie, pamięć z ECC, według NVIDIA obsługa MIG (podział karty na maksymalnie 4 odrębne instancje). Modelu nie trzeba dzielić między karty.
- Wady RTX PRO 6000 Blackwell: wysoka cena jednej karty. Edycja Workstation pobiera do 600 W. Server Edition jest przeznaczona do serwerów rack z kontrolowanym przepływem powietrza i jest u nas dostępna w przedsprzedaży z dostawą w ciągu około 2 miesięcy.
Workstation, Max-Q czy Server Edition?
Wszystkie trzy edycje mają 96 GB GDDR7 z ECC. Różnią się poborem mocy i chłodzeniem:
- Workstation Edition: 600 W, chłodzenie z przepływem powietrza przez kartę, 1 792 GB/s. Najwyższa wydajność do stacji biurkowej.
- Max-Q: 300 W, chłodzenie aktywne, ta sama przepustowość 1 792 GB/s, niższa wydajność teoretyczna (3 511 wobec 4 000 TOPS FP4). Lepszy wybór przy kilku kartach w jednej obudowie.
- Server Edition: do 600 W (regulowany), 1 597 GB/s, wersja do serwerów chłodzona powietrzem lub cieczą.
Kiedy potrzebne są dwie i więcej kart?
Więcej kart potrzeba, gdy model wraz z zapasem przekracza pamięć jednej karty: powyżej 32 GB w przypadku RTX 5090 i powyżej 96 GB w przypadku RTX PRO 6000. Drugim powodem jest większa liczba jednoczesnych użytkowników, przy której rośnie KV cache.

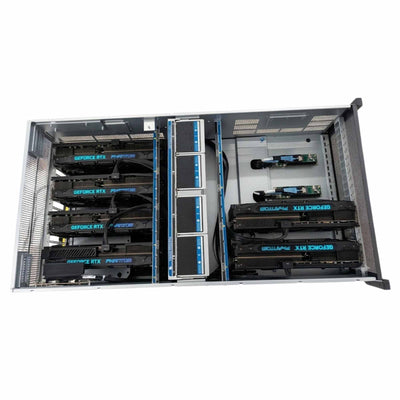
Powyżej 96 GB VRAM najtańszy zestaw z RTX PRO 6000 w naszej ofercie wychodzi taniej w przeliczeniu na 1 GB pamięci niż najtańszy zestaw z RTX 5090 (5 932 wobec 8 609 Kč). Serwer z 4× RTX PRO 6000 (384 GB) kosztuje 2 277 990 Kč, serwer z 8× RTX 5090 (256 GB) 2 238 290 Kč. Za niemal tę samą cenę otrzymują Państwo więc o 128 GB VRAM więcej i o połowę mniej kart.
Ile kosztują nasze zestawy do lokalnej AI?
Najtańszy zestaw z RTX 5090 kosztuje 200 990 Kč, z RTX PRO 6000 Blackwell 625 290 Kč. Ceny dotyczą najtańszych wariantów każdej konfiguracji na dzień 4.11.2026 i zawierają VAT:
| Zestaw | VRAM łącznie (GB) | Cena od (Kč z VAT) | Kč za 1 GB VRAM |
|---|---|---|---|
| ASUS ROG G700 – RTX 5090 (gotowy komputer, 64 GB RAM) | 32 | 200 990 | 6 281 |
| Stacja robocza AI PC Praha – RTX 5090, 128 GB RAM | 32 | 331 290 | 10 353 |
| Stacja robocza AI PC Praha – RTX PRO 6000, 128 GB RAM | 96 | 625 290 | 6 513 |
| Serwer AI PC Praha Rome – 2× RTX 5090 | 64 | 647 790 | 10 122 |
| Serwer AI PC Praha Rome – 4× RTX 5090 | 128 | 1 101 890 | 8 609 |
| Serwer AI PC Praha Rome – 2× RTX PRO 6000 | 192 | 1 235 790 | 6 436 |
| Serwer AI PC Praha Rome – 4× RTX PRO 6000 | 384 | 2 277 990 | 5 932 |
| Serwer AI PC Praha Genoa – 6× RTX PRO 6000 | 576 | 4 450 890 | 7 727 |
| Serwer AI PC Praha Rome Dual – 8× RTX 5090 | 256 | 2 238 290 | 8 743 |
| Serwer AI PC Praha Rome Dual – 8× RTX PRO 6000 | 768 | 4 590 290 | 5 977 |
| Serwer AI PC Praha Turin Dual – 16× RTX PRO 6000 | 1 536 | 9 727 990 | 6 333 |
| NVIDIA DGX Spark (pamięć współdzielona, 273 GB/s) | 128 | 220 090 | 1 719 |
Zestawy PC Praha składamy na zamówienie, a przy nich wybierają Państwo kartę, pamięć operacyjną i dysk. Gwarancja wynosi 24 miesiące. W konfiguratorze znajdą Państwo też RTX 5080, RTX 4090, NVIDIA L4 i L40 oraz Intel Arc Pro B70. Karta Arc Pro B70 nie obsługuje CUDA, dlatego warto wcześniej sprawdzić, czy Państwa oprogramowanie będzie na niej działać.
DGX Spark to mały komputer ze 128 GB pamięci współdzielonej między procesorem a grafiką. NVIDIA podaje, że jeden taki komputer udźwignie model do 200 mld parametrów. Maszyny z układem GB10 są u nas najtańsze w przeliczeniu na 1 GB pamięci, ale przepustowość 273 GB/s jest około 6,6× niższa niż w RTX 5090.
Ile prądu pobierają zestawy AI i jakiego zasilania potrzebują?
Stacja robocza z jedną kartą pobiera przy pełnym obciążeniu około 0,9 kW, serwer z 4 kartami około 2,7 kW. Szacunek w tabeli to suma poboru mocy kart według NVIDIA, procesora i pozostałych komponentów według naszego konfiguratora. Koszt za godzinę liczymy przy cenie prądu w domu 4,5 Kč/kWh (orientacyjnie, typowo czeska taryfa dwudziestogodzinna D57d; przy zwykłej D02d około 6,4 Kč/kWh, zob. Ile kosztuje prąd do kopania).

| Zestaw | Pobór mocy przy pełnym obciążeniu (W) | Prąd przy 230 V (A) | Koszt prądu za godzinę pełnego obciążenia (Kč) |
|---|---|---|---|
| Stacja z 1× RTX 5090 | 865 | 3,8 | 3,89 |
| Stacja z 1× RTX PRO 6000 | 890 | 3,9 | 4,00 |
| Serwer z 2× RTX 5090 | 1 520 | 6,6 | 6,84 |
| Serwer z 2× RTX PRO 6000 | 1 570 | 6,8 | 7,07 |
| Serwer z 4× RTX 5090 | 2 670 | 11,6 | 12,02 |
| Serwer z 4× RTX PRO 6000 | 2 770 | 12,0 | 12,46 |
| Serwer z 8× RTX 5090 | 5 220 | 22,7 | 23,49 |
| Serwer z 8× RTX PRO 6000 | 5 420 | 23,6 | 24,39 |
| Serwer z 16× RTX PRO 6000 | 10 220 | 44,4 | 45,99 |
| NVIDIA DGX Spark | do 240 (zasilacz) | 1,0 | 1,08 |
RTX PRO 6000 liczymy z 600 W. W edycji Max-Q (300 W) pobór mocy jest niższy o 300 W na kartę. Przy zwykłym użytkowaniu karta nie utrzymuje pełnego obciążenia przez cały dzień, dlatego rzeczywiste zużycie jest zwykle niższe.
- Zasilacze: w naszych zestawach stacja ma jeden zasilacz 1 650 W, a serwer do 3 kart jeden zasilacz 2 000 W. Serwer z 4–6 kartami ma dwa zasilacze 2 000 W. Serwery ośmiokartowe mają zasilacze serwerowe 5× 1 000–1 200 W. Serwery Edge i Turin Dual mają zasilacze redundantne.
- Zasilanie 230 V: stały pobór nie powinien przekraczać około 80 % wartości bezpiecznika. Na obwodzie 16 A to około 2,9 kW. Serwer z 8 lub 16 kartami potrzebuje kilku obwodów lub serwerowni; oceni to elektryk. Szczegółowy sposób postępowania opisujemy w checkliście przygotowania miejsca.
- Chłodzenie i hałas: cała energia elektryczna zamienia się w ciepło, serwer z 4 kartami grzeje jak grzejnik elektryczny o mocy 2,7 kW. Stację roboczą budujemy z myślą o cichej pracy. Serwery rack powinny stać w serwerowni lub pomieszczeniu technicznym. Głośności w dB nie mamy jeszcze zweryfikowanej pomiarem, dlatego jej nie podajemy.
- Karty serwerowe: L40 i RTX PRO 6000 Server Edition są przeznaczone do serwerów z kontrolowanym przepływem powietrza, Server Edition także w wersji z chłodzeniem cieczą. Do zwykłej obudowy PC się nie nadają.
Jak centra danych chłodzą serwery AI i dlaczego przy największych zestawach nie wystarcza powietrze, opisujemy w artykule Serwery AI: jak wyglądają, jak się je chłodzi i co decyduje o ich cenie.
Jak wybrać kartę krok po kroku?
- Proszę wybrać model, który ma działać, i sprawdzić jego liczbę parametrów.
- Wybrać kwantyzację: Q4 dla oszczędności pamięci, Q8 lub FP16 dla wyższej dokładności.
- Obliczyć VRAM: parametry × bajty na wagę × 1,2. Przy długim kontekście lub kilku użytkownikach dodać zapas.
- W tabeli znaleźć najmniejszy zestaw, w którym model się zmieści.
- Sprawdzić pobór mocy i zasilanie w miejscu, gdzie zestaw będzie stał.
- Przesłać nam zapytanie z modelem i liczbą użytkowników – zaproponujemy konfigurację.
Dlaczego warto uruchamiać AI lokalnie i kiedy opłaca się to w porównaniu z chmurą, omawiamy w artykule Serwer AI dla firmy, do pracy i do domu.
Co dalej
- Zapytanie o serwer AI – proszę napisać, jaki model i ilu użytkowników ma obsługiwać, a przygotujemy ofertę na miarę.
- Serwery AI i GPU – wszystkie zestawy, karty i maszyny z GB10 z aktualnymi cenami.
- Czy ASIC da się przebudować na serwer AI? – dlaczego to niemożliwe i co z farmy do kopania da się wykorzystać.
Źródła
- NVIDIA: GeForce RTX 5090 – specyfikacja
- NVIDIA: porównanie GeForce RTX 5090 i RTX 5080 (przepustowość pamięci, AI TOPS)
- NVIDIA: RTX PRO 6000 Blackwell Workstation Edition
- NVIDIA: RTX PRO 6000 Blackwell Max-Q Workstation Edition
- NVIDIA: RTX PRO 6000 Blackwell Server Edition
- NVIDIA: RTX PRO 5000 Blackwell · RTX PRO 4500 Blackwell · RTX PRO 4000 Blackwell
- NVIDIA: L40 · NVIDIA: L4
- NVIDIA: DGX Spark – pamięć, przepustowość, wielkość modeli
- OpenAI: Introducing gpt-oss – parametry i pamięć gpt-oss-120b
Częste pytania
Czy do lokalnej AI wystarczy jedna RTX 5090?
Lepiej 2× RTX 5090 czy 1× RTX PRO 6000 Blackwell?
Jak obliczyć, ile VRAM potrzebuje model?
Czym różnią się RTX PRO 6000 Workstation, Max-Q i Server Edition?
Czy mogę podłączyć serwer AI do zwykłego gniazdka?
Tekst został przygotowany z pomocą AI. Fakty, liczby i procedury sprawdził Yegor.